
Article in Chinese
如何用 AI 生成角色一致的绘本视频?参考图与 Agent 工作流详解
AI 绘本视频如何保持人物和场景一致?本文介绍参考图、多图参考和 AI Agent 工作流,讲解从角色设定到分镜生成的完整制作方法。
AI 图片生成技术已经非常成熟。只需要输入一段文字,就能生成一张风格精美的绘本插画。
但是,如果想把一个完整故事制作成绘本视频,难度就会明显增加。
因为绘本视频通常不是由一张图片构成的,而是由多张具有故事连续性的图片组成。每张图片代表一个故事场景或分镜,再通过镜头运动、转场、配音等方式,最终组合成视频。
真正的难点不是生成一张漂亮的图片,而是让多张图片中的人物、场景和绘画风格保持一致。
本文将介绍如何利用 AI 图片模型的参考图能力,以及 Agent 工作流,改善绘本视频的生成质量。
本文讨论的是通用技术方案,部分能力属于可扩展方向,并不代表绘页已提供全部功能。当前绘页工作台主要通过分页脚本、参考图、样稿确认、逐页生图和视频合成完成创作;早期 Story Make Agent 是独立流程,分镜、参考图、场景图和预览需要人工审核。自动视觉质检、旁白和图生视频不属于本文对工作台现有功能的承诺。
一、为什么 AI 绘本视频容易出现人物不一致?
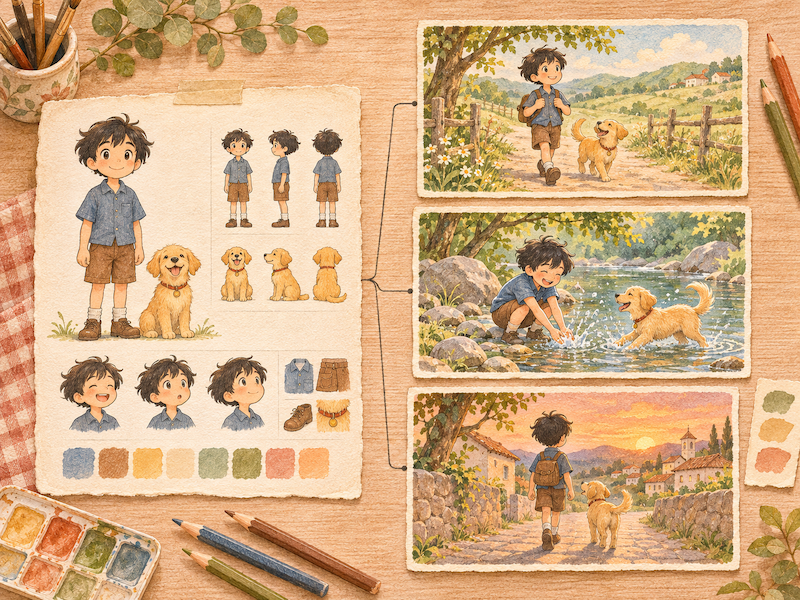
假设我们要生成一个关于小男孩和小狗的童年故事。
故事包含三个场景:
- 小男孩带着小狗在乡间小路上散步。
- 小男孩和小狗在河边玩耍。
- 傍晚,小男孩带着小狗回家。
如果每次都独立生成图片,即使使用相同的文字描述,也可能出现以下问题:
- 第一张图片中的男孩穿着蓝色衣服,第二张却变成了红色。
- 男孩的发型、脸型甚至年龄发生变化。
- 小狗的毛色和体型不一致。
- 原本统一的水彩绘本风格,在后续图片中发生偏移。
这是因为每次图片生成都可能引入新的随机变化。
对于单张插画,这些变化通常可以接受;但对于连续的绘本故事,就会影响观众的观看体验。
因此,角色一致性是 AI 绘本视频制作中需要优先解决的问题之一。
二、参考图:保持角色和场景一致性的关键
目前,部分 AI 图片生成模型支持参考图片输入。
与单纯使用文字提示词不同,参考图能够向模型提供更直观的视觉信息,例如人物外貌、服装、场景结构和绘画风格。
我们可以把参考图理解成整个绘本项目的视觉基础。
第一步:在项目开始时生成角色参考图
正式生成故事分镜之前,先确定主要人物和场景。
例如,一个童年回忆绘本项目,可以提前生成:
- 男孩的角色参考图:发型、年龄、服装和外貌特征。
- 小狗的角色参考图:毛色、体型和面部特征。
- 场景参考图:乡村房屋、道路、院子等。
- 风格参考图:统一的水彩、手绘或卡通风格。
这些图片可以组成项目的参考图库。
后续生成每一张绘本插画时,都可以从参考图库中选择合适的图片作为输入。
第二步:利用参考图生成连续分镜
有了参考图库,就可以开始生成故事分镜。
例如,在生成第二个场景「男孩和小狗在河边玩耍」时,除了提供文字描述,还可以同时提供男孩和小狗的参考图。
模型便可以结合参考图片和新的场景描述进行生成。
这样能够减少人物外貌、服装和整体风格的随机变化。
不过需要注意,参考图并不能保证百分之百的一致性。模型能力、参考图质量、提示词以及场景复杂度都会影响结果。
第三步:利用多张参考图改善复杂场景
有些图片生成模型支持同时输入多张参考图片。
这对于绘本制作尤其有帮助。
例如,一个场景可能同时涉及:
- 人物参考图:确定主角的外貌。
- 场景参考图:确定房屋或街道的结构。
- 风格参考图:统一整部作品的美术风格。
通过多张参考图,可以向模型传递更完整的视觉约束。
但参考图并不是越多越好。不同图片之间如果存在冲突,反而可能降低生成质量。
因此,应该根据当前分镜的实际需求,选择最相关的参考图片。
三、为什么还需要 AI Agent?
参考图解决了部分视觉一致性问题,但完整的绘本生成流程仍然比较复杂。
假设一个故事需要生成 20 张插画。
如果完全依靠人工操作,我们需要不断执行以下工作:
- 理解故事内容。
- 将故事拆分成分镜。
- 确定每张图片中的人物和场景。
- 从参考图库中选择图片。
- 编写对应的生成提示词。
- 调用图片生成模型。
- 检查生成结果,不合格时重新生成。
这是一套重复性较高、但又需要一定判断能力的工作流。
AI Agent 的价值,就是将这些步骤组织起来,并辅助完成其中的决策。
例如,Agent 可以先分析整个故事,提取主要人物、地点和风格信息,再根据每个分镜的内容选择对应参考图。
对于生成后的图片,还可以引入视觉模型检查人物外貌、服装和场景是否符合预期。
如果发现明显问题,可以调整提示词或参考图片,再次生成。
Agent 的作用不是替代图片生成模型,而是负责组织整个生成过程,让各个步骤之间保持连续性。
四、完整的 AI 绘本视频生成工作流
一个相对完整的生成流程,可以分成六个阶段。
1. 故事理解
用户输入故事文本,AI 分析故事情节、主要人物、时间地点和情绪变化。
2. 分镜规划
将故事拆分成多个独立画面,并为每个分镜生成画面描述。
3. 参考图库建立
生成或上传人物、场景和风格参考图,为后续创作提供视觉基础。
4. 分镜图片生成
Agent 根据当前分镜,选择合适的参考图片和提示词,调用图片生成模型。
5. 图片质量检查
检查人物是否一致、场景是否合理、画面是否符合故事要求。对于不合格的图片,可以进行局部调整或重新生成。
6. 视频合成
将生成的图片按照故事顺序排列,添加转场、镜头运动、字幕、旁白和背景音乐,最终导出绘本视频。
需要特别说明的是,绘本视频不一定需要使用视频生成模型。对于以静态插画为主的作品,也可以通过图片编排、镜头运动和音视频合成实现。
如果希望角色在画面中真实运动,则可以进一步使用图生视频模型。
五、如何进一步提高绘本生成质量?
在实际制作过程中,还有几个值得注意的细节。
第一,先确定角色,再生成故事。
不要等到生成第十张图片时,才发现主角的外貌已经发生明显变化。
第二,建立可复用的参考图库。
把人物、场景和风格参考图保存下来,避免每次生成都重新设定。
第三,控制单张图片的复杂度。
当一张图片同时出现大量人物、复杂动作和多个场景元素时,一致性往往更难控制。
第四,对关键分镜进行人工审核。
即使使用 Agent 自动化工作流,也不意味着可以完全跳过人工检查。
第五,允许局部重新生成。
如果 20 张分镜中只有两张存在问题,应该优先重新生成这两张,而不是重新制作整个项目。
六、总结
AI 绘本视频制作并不只是简单地调用图片生成 API。
真正重要的是建立一套完整的创作流程,让人物、场景和画面风格能够在多个分镜之间保持相对一致。
参考图提供视觉约束,图片生成模型负责创作画面,而 Agent 则负责组织故事、分镜、参考图选择和质量检查。
三者结合,能够降低制作连续绘本视频的难度,让最终结果更加稳定、可控。
对于希望制作童年回忆、家庭故事、儿童绘本或者故事短视频的创作者来说,这种工作流提供了一种值得尝试的制作方式。
想亲自尝试制作 AI 绘本视频?
你可以使用我们的 AI 绘本生成工具,将自己的故事转化成连续的绘本插画,并进一步制作成视频。